
1. Büyük Dil Modelleri Nasıl Çalışır
Bir aracı ustaca kullanmanın ön koşulu, o aracın hangi ilkeyle çalıştığını bilmektir. Bir mühendis, kullandığı sonlu elemanlar yazılımının çözücü algoritmasını bilmeden de sonuç üretebilir; ancak sonucun ne zaman güvenilir olmadığını fark edemez. Büyük dil modelleri için de durum aynıdır. Bu bölümde ele alacağımız kavramlar — token, gömme vektörü, dikkat mekanizması, olasılıksal üretim, bağlam penceresi — kitabın geri kalanındaki her tekniğin dayanağıdır.
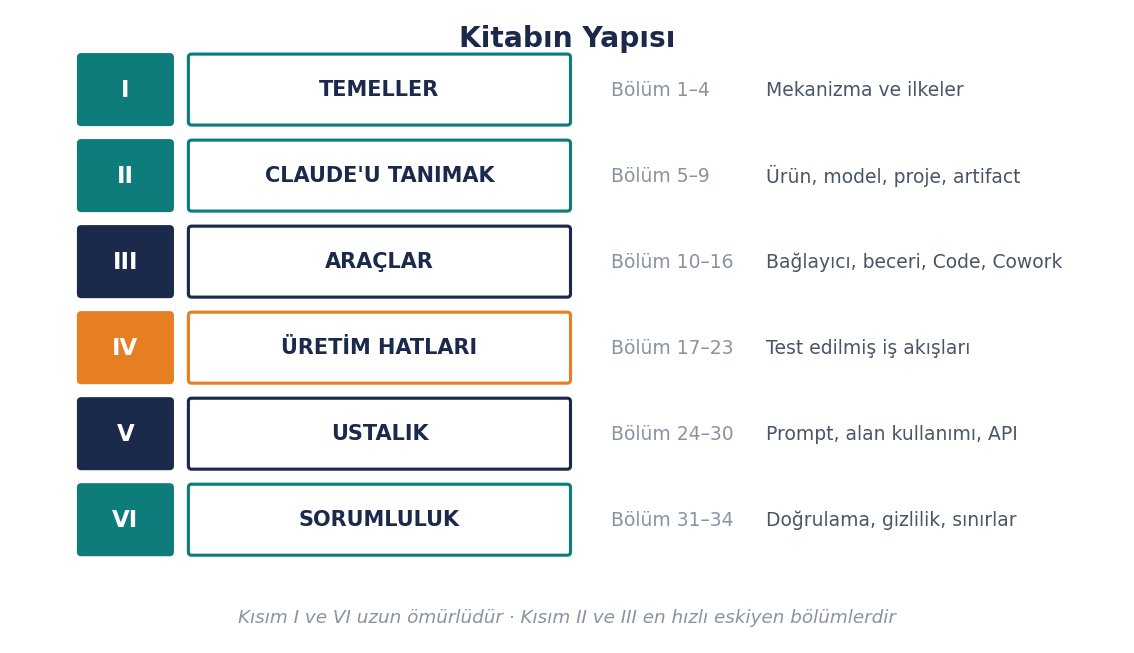
Şekil I.1 — Kitabın yapısı ve kısımların eskime hızı.
Bu bölüm matematiksel türetme içermez. Amaç, model davranışını öngörebilecek kadar sağlam bir zihinsel model kurmaktır.
1.1 Yaygın Bir Yanılgıyla Başlamak
Büyük dil modelleri hakkında en yaygın yanılgı, bunların bir veri tabanından bilgi çektiğidir. Kullanıcılar sıklıkla modeli, sorulan soruya karşılık gelen kaydı bulup getiren bir arama motoru gibi düşünür. Bu tasavvur yanlıştır ve pratikte ciddi hatalara yol açar.
Model, eğitim sırasında gördüğü metinleri saklamaz. Onun yerine, dilin istatistiksel yapısını parametrelerine kodlar. Bir cevap ürettiğinde, hafızasından bir kaydı geri çağırmaz; o an, kelime kelime, yeni bir metin üretir. Bu ayrım kitabın tamamı boyunca karşımıza çıkacak: modelin ürettiği her cümle, bir alıntı değil, bir tahmindir.
1.2 Token: Metnin Yapı Taşı
Model metni harf harf veya kelime kelime işlemez. Metin önce token adı verilen alt birimlere ayrılır. Token, kimi zaman tam bir kelimeye, kimi zaman bir kelimenin parçasına, kimi zaman tek bir noktalama işaretine karşılık gelir.
Bu ayrıştırma işlemine tokenizasyon, bunu yapan bileşene ise tokenizer denir. Tokenizer, eğitim verisinde sık geçen karakter dizilerine tek bir token atar; nadir geçenleri ise birden fazla parçaya böler.
Bu örnek önemli bir asimetriyi gösterir: Türkçe metinler, İngilizce metinlere kıyasla aynı anlam için genellikle daha fazla token tüketir. Bunun iki nedeni vardır. Birincisi, çoğu tokenizer ağırlıklı olarak İngilizce metinle eğitilmiştir, dolayısıyla İngilizce kelimeler tek tokene sığarken Türkçe kelimeler bölünür. İkincisi, Türkçenin sondan eklemeli yapısı uzun kelimeler üretir ve bu kelimeler parçalanır.
Pratik sonucu şudur: aynı içerik için Türkçe kullanmak, İngilizce kullanmaya göre daha fazla token maliyeti doğurur ve bağlam penceresini daha hızlı doldurur. Bu, Türkçe kullanmaktan vazgeçmek için bir gerekçe değildir; ancak çok uzun belgelerle çalışırken farkında olunması gereken bir kısıttır.
Token Neden Önemli?
- Ücretlendirme token başına yapılır — girdi ve çıktı ayrı ayrı sayılır.
- Bağlam penceresi token cinsinden ölçülür.
- Modelin gördüğü birim token olduğu için, harf sayma veya kelimeyi tersten yazma gibi görevlerde beklenmedik hatalar yapabilir.
Son madde, sık rastlanan bir davranışı açıklar: modele bir kelimedeki harf sayısını sorduğunuzda yanılabilir. Bunun nedeni zekâ eksikliği değil, modelin o kelimeyi harf dizisi olarak değil, birkaç tokenlik bir bütün olarak görmesidir.
1.3 Gömme Vektörleri ve Anlam Uzayı
Tokenler sayısal olarak temsil edilmelidir; model metinle değil sayılarla çalışır. Her token, gömme vektörü (embedding) adı verilen yüzlerce ya da binlerce boyutlu bir sayı dizisine dönüştürülür.
Bu vektörlerin dikkat çekici özelliği, anlamsal ilişkileri geometrik olarak kodlamalarıdır. Benzer anlamlı tokenler bu çok boyutlu uzayda birbirine yakın konumlanır. "Kiriş" ve "kolon" vektörleri birbirine, "kiriş" ve "tarçın" vektörlerinden çok daha yakındır.
Bu, modelin eşanlamlıları, bağlamsal benzerlikleri ve kavramsal ilişkileri yakalayabilmesinin temelidir. Aynı zamanda, farklı dillerde yazılmış aynı kavramın benzer bölgelere düşmesi sayesinde çok dilli yeteneğin de kaynağıdır.
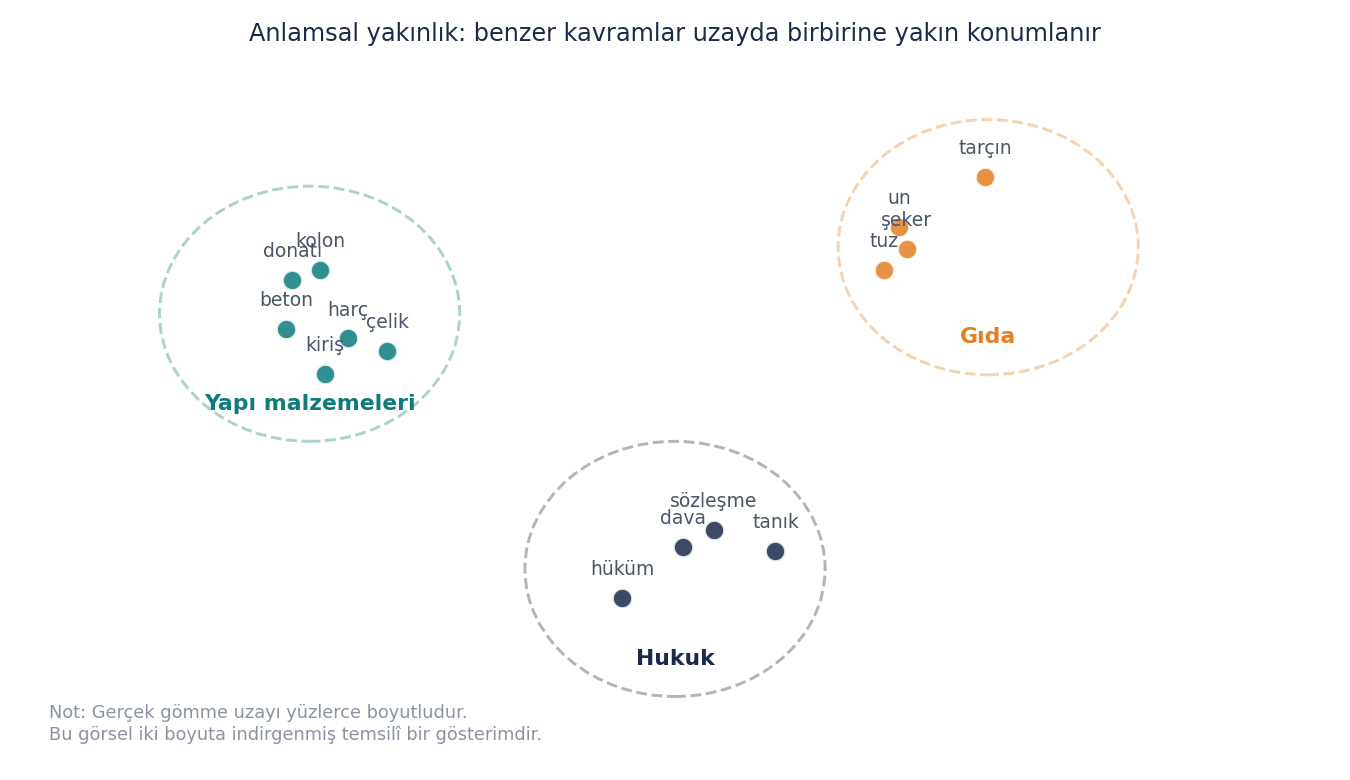
Şekil 1.1 — Anlamsal yakınlık. Benzer kavramlar çok boyutlu uzayda birbirine yakın konumlanır.
1.4 Transformer Mimarisi ve Dikkat Mekanizması
Günümüzdeki tüm büyük dil modellerinin temelinde, 2017 yılında tanıtılan transformer mimarisi bulunur. Bu mimarinin belirleyici bileşeni dikkat mekanizmasıdır (attention).
Dikkat mekanizmasının çözdüğü problem şudur: bir kelimenin anlamı, cümledeki diğer kelimelere bağlıdır. "Yüzey çatladı" ile "gülümseyerek yüzü çatladı" cümlelerinde ortak kök farklı anlamlar taşır. Model, her tokeni işlerken, bağlamdaki diğer tokenlerin hangilerine ne kadar "dikkat edeceğini" hesaplar.
Somut bir örnek: "Betonarme kirişin donatısı yetersizdi çünkü kesiti küçüktü" cümlesinde "kesiti" kelimesinin neye ait olduğunu belirlemek için model, bu tokenin "kiriş" tokeniyle olan ilişkisine yüksek dikkat ağırlığı verir. Bu hesaplama cümledeki her token çifti için yapılır ve modelin onlarca katmanı boyunca tekrarlanır.
Transformer mimarisinin önceki yaklaşımlara üstünlüğü, bu hesaplamayı paralel yapabilmesidir. Kendisinden önceki tekrarlayan sinir ağları metni sırayla, kelime kelime işlemek zorundaydı. Transformer tüm bağlamı aynı anda görebildiği için hem çok daha büyük veri kümeleriyle eğitilebilir hem de uzun mesafeli ilişkileri daha iyi yakalar.
1.5 Eğitim: Modelin Yeteneği Nereden Gelir?
Bir dil modelinin oluşumu genellikle üç aşamada gerçekleşir.
Ön Eğitim (Pre-training)
Model, çok büyük hacimli metin üzerinde tek bir görevle eğitilir: verilen metin parçasının ardından gelecek tokeni tahmin etmek. Bu basit görev, yeterince büyük ölçekte tekrarlandığında dilbilgisi, olgusal bilgi, akıl yürütme kalıpları ve hatta programlama becerisi gibi yetenekleri ortaya çıkarır. Bu aşama hesaplama açısından en pahalı kısımdır.
İnce Ayar (Fine-tuning)
Ön eğitimden çıkan model, metin tamamlamada iyidir ancak talimat izlemede zayıftır. İnce ayar aşamasında, soru-cevap ve talimat-yanıt biçiminde düzenlenmiş, daha küçük ve özenle hazırlanmış veri kümeleriyle eğitim sürdürülür. Model böylece bir asistan gibi davranmayı öğrenir.
İnsan Geri Bildirimiyle Pekiştirmeli Öğrenme
Son aşamada, modelin ürettiği farklı yanıtlar insanlar tarafından karşılaştırılarak derecelendirilir. Bu tercih verisiyle model, hangi tür yanıtların daha yararlı, doğru ve zararsız olduğunu öğrenir. Bu aşama, modelin üslubunu, reddetme davranışlarını ve genel yardımseverlik düzeyini belirler.
Bu üç aşamalı yapıyı bilmek pratik bir sonuç doğurur: modelin olgusal bilgisi ön eğitim verisinden gelir ve o verinin kesim tarihiyle sınırlıdır. Buna karşılık modelin davranışı, üslubu ve talimat izleme kalitesi sonraki aşamalarda şekillenir. Dolayısıyla "model güncel bilgiyi bilmiyor" ile "model talimatı anlamadı" birbirinden tamamen farklı iki sorundur ve farklı çözümler gerektirir.
1.6 Çıkarım: Yanıt Nasıl Üretilir?
Kullanıcı bir soru yazdığında ne olur? Model, o ana kadarki tüm metni — sistem talimatı, sohbet geçmişi ve yeni soru — girdi olarak alır ve bir sonraki tokenin olasılık dağılımını hesaplar. Sözlüğündeki her olası token için bir olasılık değeri üretir.
Ardından bu dağılımdan bir token seçilir, seçilen token girdinin sonuna eklenir ve süreç yeni baştan tekrarlanır. Yanıt bu şekilde, token token büyüyerek oluşur. Model yanıtın tamamını önceden planlayıp yazmaz; her adımda yalnızca bir sonraki adımı belirler.
Bu mekanizma iki önemli sonuç doğurur. Birincisi, aynı soruya iki kez sorulduğunda farklı yanıtlar alınabilir; çünkü seçim tamamen belirlenimci değildir. İkincisi ve daha kritik olanı: model, doğru olduğundan emin olduğu için değil, istatistiksel olarak olası olduğu için bir şey söyler.
Bu nokta, kitabın en önemli tek cümlesini içerir: modelin kendinden emin görünmesi, doğru olduğunun kanıtı değildir. Bölüm 2 bu konuyu ayrıntılı ele alacaktır.
1.7 Bağlam Penceresi
Bağlam penceresi, modelin tek seferde işleyebileceği azami token miktarıdır. Bu pencere, sistem talimatını, sohbetin tüm geçmişini, yüklenen belgeleri ve üretilecek yanıtı kapsar.
Bağlam penceresinin en kritik özelliği, modelin kalıcı hafızası olmamasıdır. Model, sohbetin başında söylediklerinizi, o metin hâlâ bağlam penceresi içinde olduğu için hatırlar; bir hafızaya kaydettiği için değil. Pencere dolduğunda en eski içerik dışarıda kalır ve model onu artık göremez.
Güncel modellerde bağlam pencereleri hızla büyümüştür. Örneğin Claude Sonnet 5, varsayılan olarak bir milyon tokenlik bağlam penceresiyle çalışır. Bu, birkaç yüz sayfalık bir belgenin tek seferde işlenebilmesi anlamına gelir.
Kaynak: Claude Platform Dokümantasyonu, "What's new in Claude Sonnet 5" — https://platform.claude.com/docs — 25 Ağustos 2026 itibarıyla doğrulanmıştır.
Büyük Bağlam Her Zaman Daha İyi mi?
Hayır. Üç ayrı kısıt vardır.
- Maliyet: Bağlamdaki her token ücretlendirilir ve her yeni mesajda tüm bağlam yeniden işlenir.
- Hız: Uzun bağlam, yanıt süresini uzatır.
- Dikkat seyrelmesi: Çok uzun bağlamlarda modelin ortalarda kalan bilgiye gösterdiği dikkat zayıflayabilir. Kritik talimatları bağlamın başına veya sonuna yerleştirmek pratik bir önlemdir.
Bu üçüncü nokta, ileri seviye kullanımda sık karşılaşılan bir sorunu açıklar: elli sayfalık bir belgenin ortasındaki bir ayrıntı gözden kaçabilir. Çözüm, belgeyi bölümlere ayırıp odaklı sorular sormaktır.
1.8 Düşünme Modu: Yanıt Öncesi Akıl Yürütme
Modern modellerin bir kısmı, nihai yanıtı üretmeden önce kendi içinde bir akıl yürütme aşaması yürütür. Bu aşamada model, problemi parçalara ayırır, ara adımlar hesaplar, alternatifleri değerlendirir ve ancak ondan sonra yanıtını yazar.
Bu mekanizmanın neden işe yaradığı, 1.6'daki üretim mantığından anlaşılabilir. Model her adımda yalnızca bir sonraki tokeni belirlediği için, karmaşık bir problemde doğrudan sonuca atlaması hata riskini artırır. Ara adımları metin olarak üretmek, sonraki adımların üzerine inşa edebileceği bir zemin oluşturur.
Anthropic'in güncel modellerinde bu yapı değişmiştir: Claude Sonnet 5 ve sonrasında elle açılıp kapatılan bir düşünme anahtarı bulunmaz; bunun yerine adaptif düşünme varsayılan olarak etkindir ve modelin ne kadar akıl yürüteceği, seçilen çaba (effort) seviyesine göre otomatik olarak ayarlanır.
Kaynak: Claude Platform Dokümantasyonu, "What's new in Claude Sonnet 5" ve "Models overview" — https://platform.claude.com/docs — 25 Ağustos 2026 itibarıyla doğrulanmıştır. Bu mekanizma platformdan platforma farklılık gösterir; her platformun güncel davranışı ilgili bölümde ele alınacaktır.
Ne Zaman Fayda Sağlar, Ne Zaman Sağlamaz?
| Görev türü | Akıl yürütmenin katkısı |
|---|---|
| Çok adımlı hesaplama, matematiksel türetme | Yüksek |
| Karmaşık kod hata ayıklama | Yüksek |
| Çelişkili kısıtların dengelenmesi, tasarım kararı | Yüksek |
| Mantık problemleri, çıkarım zincirleri | Yüksek |
| Basit olgusal soru | Düşük — gereksiz maliyet |
| Metin biçimlendirme, çeviri, özetleme | Düşük |
| Yaratıcı yazım | Değişken — bazen üslubu kısıtlar |
1.9 Bu Bilgi Pratikte Ne İşe Yarar?
Buraya kadar anlatılanlar soyut görünebilir. Ancak bu kavramların her biri, ilerideki bölümlerde somut bir tekniğe dönüşecektir.
| Kavram | Pratik sonucu |
|---|---|
| Token | Maliyet öngörüsü; Türkçe metnin daha fazla token tükettiği bilgisi |
| Olasılıksal üretim | Halüsinasyon riski; her olgusal iddianın doğrulanması gereği |
| Bağlam penceresi | Uzun belgeleri bölme stratejisi; kritik talimatı başa/sona koyma |
| Hafızasızlık | Her sohbetin sıfırdan başladığı; bağlamın elle taşınması gereği |
| Dikkat mekanizması | Yapılandırılmış talimatın (başlık, etiket) neden işe yaradığı |
| Eğitim aşamaları | Bilgi eksikliği ile talimat sorununun ayırt edilmesi |
| Akıl yürütme | Hangi görevde derin düşünmenin maliyete değdiği |
1.10 Bölüm Özeti
- Model bir veri tabanı değildir; metin üretir, kayıt getirmez.
- Metin tokenlere ayrılır; Türkçe, İngilizceye kıyasla daha fazla token tüketir.
- Tokenler anlamsal ilişkileri kodlayan vektörlere dönüştürülür.
- Dikkat mekanizması, her tokenin bağlamdaki diğer tokenlerle ilişkisini hesaplar.
- Yetenek üç aşamalı eğitimden gelir: ön eğitim, ince ayar, insan geri bildirimi.
- Yanıt, her adımda bir sonraki en olası tokenin seçilmesiyle oluşur.
- Akıcılık doğruluğun kanıtı değildir; halüsinasyon mekanizmanın doğal sonucudur.
- Bağlam penceresi modelin görüş alanıdır; kalıcı hafıza değildir.
- Akıl yürütme modu karmaşık görevlerde fayda sağlar, basit görevlerde maliyet doğurur.
Güncellik kontrolü: Bu bölümdeki kavramsal içerik yavaş eskiyen niteliktedir. Somut model özellikleri (bağlam penceresi boyutu, düşünme mekanizması) 25 Ağustos 2026 itibarıyla doğrulanmıştır. Güncel değerler için: https://platform.claude.com/docs/en/about-claude/models/overview